





Испытан первый нейрочип, который возвращает и речь, и жесты
В Калифорнийском университете в Сан-Франциско испытали первый мультимодальный нейроимплантат, предназначенный для одновременного декодирования и речи, и жестикуляции. Результаты экспериментов, которые дарят надежду людям с глубоким параличом, увидели свет в журнале Nature Neuroscience.
«В повседневной жизни жесты играют важную роль в общении. Сказать „может быть“ и кивнуть — далеко не то же самое, что просто покачать головой», — считает нейроинженер Саманта Брослер, ведущий автор исследования.
Интерфейсы «мозг–компьютер» (BCI) расширили возможности людей с параличом либо в речи, либо в движениях, однако попытки сочетания вербальной и невербальной коммуникации не удавались — ведь для этого нужно снимать нейронные сигналы с большей площади сенсомоторной коры и обучать управляемую чипом модель на смешанных данных.
Новый BCI вживили трем людям, двое из которых утратили речь и подвижность после инсульта ствола мозга, еще одного парализовало в результате болезни Стивена Хокинга — бокового амиотрофического склероза.
Сначала записали активность мозга участников, пока те многократно пытались произнести стандартные фразы — например, «привет», «приятно познакомиться» и «как дела?» — или выполнить типичные жесты, такие как взмах руки, хлопок и покачивание головой. В одних случаях пациенты пытались делать это по отдельности, в других — одновременно. На основе этих данных персонализированные модели искусственного интеллекта научились предсказывать их предполагаемые фразы и жесты. На этом этапе одна участница выбыла из испытаний.
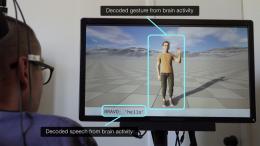
Для проверки качества обучения моделей испытуемые пытались повторять различные пары фраз и жестов, отображавшиеся на экране, о которых нейросети не знали. Результаты отображались в виде движений аватара, речь выдавалась в текстовой форме.
Решение применить аватары, срисованные с участников, а не заставлять их говорить и жестикулировать в реальности, Брослер объясняет тем, что так проще продемонстрировать многоэффекторное действие нейроимплантата — прежде всего, для самих пациентов.
Предполагаемые жесты и речь у участника, названого в статье Bravo-1r (инсульт), были предсказаны с точностью 88% и 84% соответственно, а у Bravo-6 (БАС) — 66% и 70%.
«Если бы эти модели работали на уровне случайного угадывания, точность составляла бы около 9% — так что это правда круто», — не скрывает гордости исследовательница.
Она поделилась дальнейшими планами. Во-первых, это, конечно, расширение набора жестов и слов, которые может распознавать модель — в испытании их было по 10 плюс 100 возможных комбинаций, чего для общения совершенно недостаточно. Во-вторых, устройство хотят сделать беспроводным. В-третьих, и это задача-максимум для ученых — в перспективе нейрочип должен управлять не аватаром, а движениями людей (если мышцы и суставы в хорошем состоянии) и синтезировать голос.